Metody šíření distribuce
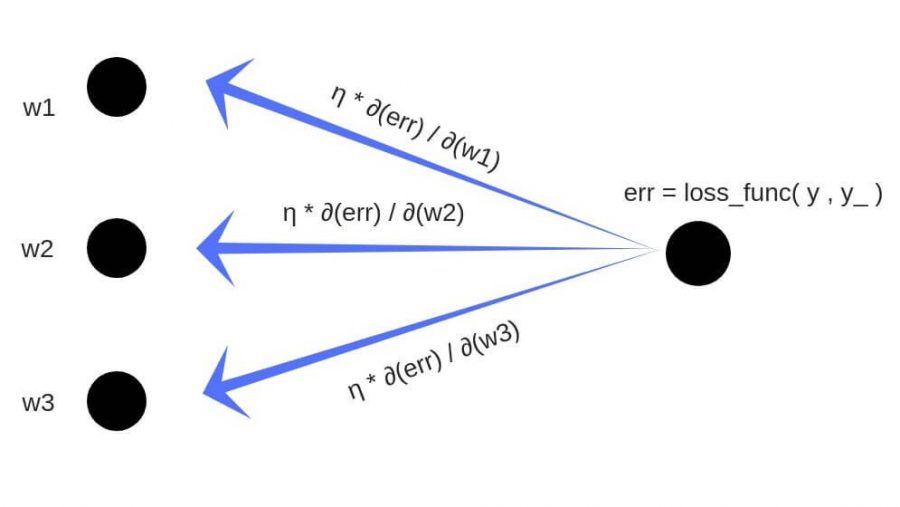
Zpětná propagace je způsob, jak trénovat neuronovou síť. Cíle zpětného šíření jsou jednoduché: upravit každou váhu v poměru k tomu, jak moc přispívá k celkové chybě. Pokud iterativně snížíme chybu každé váhy, nakonec budeme mít sadu vah, které dávají dobré předpovědi.
Aktualizace pravidla řetězce
Dopředné šíření si lze představit jako dlouhou řadu vnořených rovnic. Pokud takto uvažujete o dopředném šíření, pak je zpětné šíření pouze aplikací řetězová pravidla (komplexní funkční diferenciace) k nalezení derivací ztrát vzhledem k jakékoli proměnné ve vnořené rovnici. Vezmeme-li v úvahu funkci dopředného šíření:
f(x)=A(B(C(x)))
A, B a C jsou aktivační funkce na různých vrstvách. Pomocí řetězového pravidla můžeme snadno vypočítat derivaci f(x) vzhledem k x:
f′(x)=f′(A)⋅A′(B)⋅B′(C)⋅C′(x)
Co derivace s ohledem na B? Najít derivaci vzhledem k B, můžete předstírat, že B(C(x)) je konstanta, nahradit ji zástupnou proměnnou Ba pokračujte v hledání derivátu s ohledem na B Standard.
f′(B)=f′(A)⋅A′(B)
Tato jednoduchá metoda se rozšiřuje na jakoukoli proměnnou v rámci funkce a umožňuje nám přesně určit dopad každé proměnné k celkovému výsledku.
Použití pravidla řetězu
Použijme řetězové pravidlo k výpočtu derivace ztráty s ohledem na jakoukoli váhu v síti. Pravidlo zřetězení nám pomůže určit, jak moc každá váha přispívá k naší celkové chybě a směr, kterým by měla být každá váha aktualizována, aby se chyba snížila. Zde jsou rovnice, které potřebujete k vytvoření prognózy a výpočtu celkové chyby nebo ztráty:
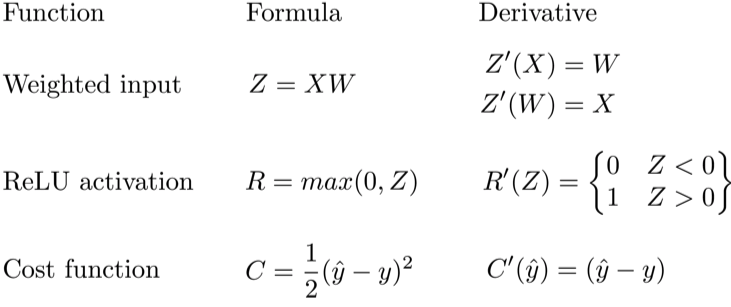
Vzhledem k síti skládající se z jednoho neuronu lze celkovou ztrátu neuronové sítě vypočítat jako:
Cena=C(R(Z(XW)))
Pomocí řetězového pravidla můžeme snadno najít derivaci ztráty vzhledem k hmotnosti W.
C′(W)=C′(R)⋅R′(Z)⋅Z′(W)=(y^−y)⋅R′(Z)⋅X
Nyní, když máme rovnici pro výpočet derivace ztráty s ohledem na jakoukoli váhu, podívejme se na příklad neuronové sítě:
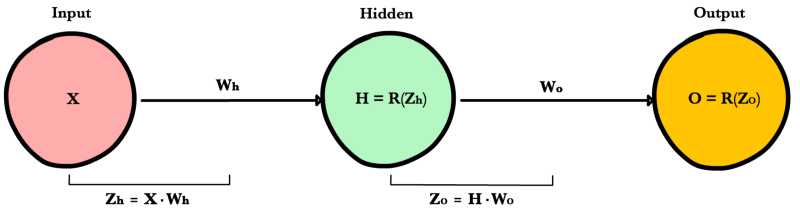
Jaký je derivát ztráty vzhledem k Wo?
Co takhle Wh? Abychom to zjistili, jednoduše pokračujeme ve smyčce zpět do naší funkce, rekurzivně aplikujeme pravidlo řetězení, dokud se nedostaneme k funkci, která má prvek Wh.
A jen pro zajímavost, co kdyby naše síť měla 10 skrytých vrstev. Jaká je derivace ztráty pro první váhu w1?
C(w1)=(dC/dy^)⋅(dy^/dZ11)⋅(dZ11/dH10)⋅(dH10/dZ10)⋅(dZ10/dH9)⋅(dH9/dZ9)⋅(dZ9/dH8)⋅(dH8/dZ8)⋅(dZ8/dH7)⋅(dH7/dZ7)⋅(dZ7/dH6)⋅(dH6/dZ6)⋅(dZ6/dH5)⋅(dH5/dZ5)⋅(dZ5/dH4)⋅(dH4/dZ4)⋅(dZ4/dH3)⋅(dH3/dZ3)⋅(dZ3/dH2)⋅(dH2/dZ2)⋅(dZ2/dH1)⋅(dH1/dZ1)⋅(dZ1/dW1)
Všimli jste si vzoru? Množství výpočtů potřebných k výpočtu ztrát derivátů se zvyšuje, jak se naše síť prohlubuje. Také poznamenejte redundance v našich derivačních výpočtech. Derivace ztráty každé vrstvy přidává dva nové prvky k prvkům, které již byly spočítány vrstvami nad ní. Co kdyby existoval nějaký způsob, jak zachránit naši práci a vyhnout se těmto opakovaným výpočtům?
Úspora práce s zapamatováním
Pamatování je termín v informatice, který má jednoduchý význam: nepočítejte stále stejné věci. Při zapamatování ukládáme dříve vypočítané výsledky, abychom se vyhnuli přepočítávání stejné funkce. To je užitečné pro urychlení rekurzivních funkcí, z nichž jednou je zpětné šíření. Věnujte pozornost vzoru v derivačních rovnicích níže.
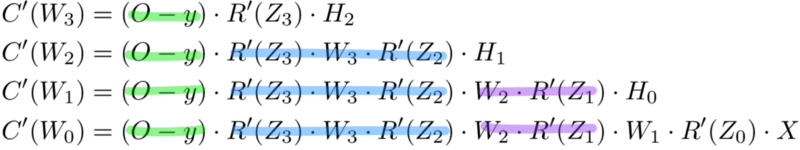
Každá z těchto vrstev přepočítává stejné derivace! Místo vypisování dlouhých derivačních rovnic pro každou váhu můžeme použít zapamatování, abychom si ušetřili práci, když vracíme chybu přes síť. K tomu definujeme 3 rovnice (níže), které společně vyjadřují ve stručné formě všechny výpočty potřebné pro backpropagation. Matematika je stejná, ale rovnice poskytují pěknou zkratku, kterou můžeme použít k udržení přehledu o výpočtech, které jsme již provedli, a uložení naší práce při pohybu zpět po síti.
Nejprve počítáme chyba výstupní vrstvy a výsledek předejte skryté vrstvě před ním. Po výpočtu chyby skryté vrstvy předáme její hodnotu zpět předchozí skryté vrstvě. A tak dále a tak dále. Když se vrátíme přes síť, použijeme na každou vrstvu 3. vzorec pro výpočet derivace ztráty s ohledem na váhy této vrstvy. Tato derivace nám říká kterým směrem upravit svou váhusnížit celkové ztráty.
Poznámka: termín chyba vrstvy odkazuje na derivát ztrát s ohledem na vchod do vrstva. Odpovídá na otázku: jak se změní výstup ztrátové funkce, když se změní vstup do této vrstvy?
Chyba výstupní vrstvy
Pro výpočet chyby výstupní vrstvy je nutné najít derivaci ztráty vzhledem ke vstupu do výstupní vrstvy, Zo. To odpovídá na otázku: jak ovlivní váhy poslední vrstvy celkovou chybu v síti? Pak je derivace:
C′(Zo)=(y^−y)⋅R′(Zo)
Aby bylo nahrávání jednodušší, praktici MO obvykle nahrazují sekvenci (y^−y)∗R'(Zo) období Eo. Náš vzorec pro chybu výstupní vrstvy je tedy:
Eo=(y^−y)⋅R′(Zo)
Skrytá chyba vrstvy
Chcete-li vypočítat chybu skryté vrstvy, musíte najít derivaci ztráty s ohledem na vstup skryté vrstvy, Zh.
C′(Zh)=(y^−y)⋅R′(Zo)⋅Wo⋅R′(Zh)
Dále můžeme prvek vyměnit Eo výše, abyste zabránili duplikaci a vytvořili novou zjednodušenou rovnici pro chybu skryté vrstvy:
Eh=Eo⋅Wo⋅R′(Zh)
Tento vzorec je základem zpětného šíření. Vypočítáme chybu aktuální vrstvy a předáme váženou chybu zpět předchozí vrstvě a pokračujeme v procesu, dokud nedosáhneme naší první skryté vrstvy. Po cestě aktualizujeme váhy pomocí derivace ztráty s ohledem na každou váhu.
Derivát ztráty vzhledem k jakékoli hmotnosti
Vraťme se k našemu vzorci pro derivaci ztrát vzhledem k hmotnosti výstupní vrstvy Wo.
C′(WO)=(y^−y)⋅R′(ZO)⋅H
Víme, že první část můžeme nahradit rovnicí pro chybu výstupní vrstvy Eh. H představuje aktivaci skryté vrstvy.
C'(Wo)=Eo⋅H
Abychom tedy našli derivaci ztráty vzhledem k jakékoli váze v naší síti, jednoduše vynásobíme chybu odpovídající vrstvy jejím vstupem (výstupem předchozí vrstvy).
C′(w)=CurrentLayerError⋅CurrentLayerInput
Poznámka: vstup odkazuje na aktivaci z předchozí vrstvy, nikoli na vážený vstup, Z.
Sčítání
Zde jsou poslední 3 rovnice, které dohromady tvoří základ zpětného šíření.
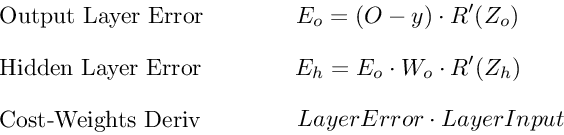
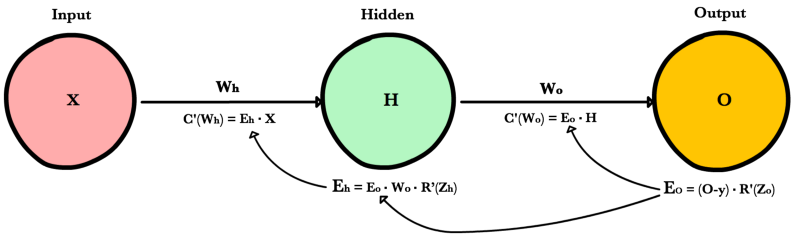
Zde je proces vizualizovaný pomocí našeho příkladu neuronové sítě výše:
Backpropagation: Ukázkový kód
def relu_prime(z): if z > 0: zpáteční 1 zpáteční 0 def cena (yHat, y): zpáteční 0.5 * (yHat - y)**2 def cost_prime(yHat,y): zpáteční yHat-y def backprop(x, y, Wh, Wo, lr): yHat = feed_forward(x, Wh, Wo) # Chyba vrstvy Eo = (yHat - y) * relu_prime(Zo) Eh = Eo * Wo * relu_prime(Zh) # Nákladová derivace pro váhy dWo = Eo * H dWh = Eh * x # Aktualizujte váhy Wh -= lr * dWh Wo -= lr * dWo
Vytvářejte videa, obrázky a avatary pomocí služby FabulaAI. Získejte 10 generací zdarma ihned po registraci!